Le robots.txt est le plus petit fichier de votre site et celui qui peut faire le plus de dégâts. Une ligne oubliée après une mise en ligne, et Google ne voit plus rien. À l’inverse, on lui prête des pouvoirs qu’il n’a pas, comme celui de « désindexer » une page. Cet article s’en tient à ce que Google documente : ce que le fichier fait, ce qu’il ne fait pas, et comment l’écrire sans se tirer une balle dans le pied.
Le robots.txt est un fichier texte placé à la racine du site qui indique aux robots d’exploration les URL qu’ils peuvent parcourir. Selon Google, il sert à gérer le trafic d’exploration et « ne sert pas à empêcher qu’une page Web figure dans les résultats » : pour cela, il faut une balise noindex. Il suit la RFC 9309, Google en lit au plus 500 Kio, le met en cache environ 24 heures, et traite un fichier absent comme une autorisation totale.
Il complète deux autres fichiers dont j’ai parlé séparément : le sitemap XML, qui liste ce que vous voulez faire découvrir, et le llms.txt avec les robots des IA, qui traite du choix d’ouvrir ou non votre site aux assistants. Ici, le robots.txt seul.
À quoi sert le robots.txt, selon Google
La page d’introduction de Google Search Central est claire : « Un fichier robots.txt indique aux robots d’exploration d’un moteur de recherche les URL auxquelles il peut accéder sur votre site. » Son rôle est de gérer le trafic d’exploration, pour éviter de surcharger le serveur avec des pages sans intérêt pour la recherche : résultats de filtres, paniers, pages d’administration, versions imprimables.
Et la même page pose la limite que tout le monde oublie : il « ne sert pas à empêcher qu’une page Web figure dans les résultats de recherche Google ». Trois précisions complètent le tableau dans l’introduction au robots.txt (nouvel onglet) :
- les instructions « ne peuvent pas obliger le robot d’exploration à respecter les règles » : les robots sérieux obéissent, les autres non ;
- « une page non autorisée dans le fichier robots.txt peut toujours être indexée si d’autres sites la référencent » ;
- différents robots peuvent interpréter la syntaxe différemment.
Autrement dit : le robots.txt ferme une porte aux robots polis. Il ne cache rien, il ne protège rien, et il ne retire rien de l’index.
Ce qu’il ne fait pas, et quoi utiliser à la place
| Vous voulez | Le bon outil | Pas le robots.txt, parce que |
|---|---|---|
| Retirer une page des résultats | Balise noindex (et laisser Google explorer la page) | Une page bloquée ne peut pas montrer sa balise noindex, et peut rester indexée sans description |
| Protéger des données privées | Mot de passe, authentification | Le fichier est public et n’empêche personne d’accéder à l’URL |
| Éviter le contenu dupliqué | Balise canonique | Bloquer les doublons empêche Google de voir la canonique |
| Économiser le budget d’exploration | Robots.txt | C’est précisément son rôle |
Le piège classique : bloquer dans le robots.txt une page que l’on vient de passer en noindex. Google ne peut plus la lire, ne voit jamais la consigne, et la page reste dans l’index pendant des mois.
La syntaxe, en cinq lignes
Le fichier se lit par groupes. Chaque groupe commence par un ou plusieurs User-agent (le robot visé) suivis de règles Allow et Disallow (chemins autorisés ou interdits). Une ligne Sitemap indique l’adresse du sitemap, pour tous les robots.
User-agent: *
Disallow: /admin/
Disallow: /panier/
Allow: /

Sitemap: https://www.exemple.fr/sitemap.xml
Selon la documentation de Google sur l’interprétation du robots.txt (nouvel onglet), seules quatre directives sont prises en compte : user-agent, allow, disallow et sitemap. Les chemins sont sensibles à la casse, * remplace une suite de caractères et $ marque la fin d’une URL. Un Disallow: vide autorise tout ; un Disallow: / interdit tout.
Mon propre fichier tient en quelques lignes : tout est ouvert, une ligne Sitemap pointe vers l’index de sitemaps, et les robots des IA sont traités explicitement, selon le choix expliqué dans le guide dédié.
Les limites officielles qu’il faut connaître
La documentation de Google fixe des règles précises, et plusieurs surprennent :
- Emplacement : à la racine du domaine, un fichier par hôte.
https://exemple.fr/robots.txtne couvre nihttps://blog.exemple.frnihttp://exemple.fr. - Taille : « Google applique une limite de taille de fichier robots.txt de 500 kibioctets (Kio). Tout contenu qui dépasse cette taille est ignoré. » Un fichier de plusieurs milliers de lignes peut donc être tronqué.
- Cache : Google met le fichier en cache environ 24 heures. Une correction n’est pas prise en compte à la minute.
- Fichier absent (404) : Google considère qu’il n’y a pas de restriction et explore tout.
- Erreur serveur (5xx) : Google suspend l’exploration pendant douze heures en réessayant, puis utilise la dernière version en cache pendant trente jours, et au-delà considère qu’il n’y a plus de restriction. Un robots.txt qui renvoie une erreur peut geler l’exploration d’un site entier.
- Norme : Google suit la RFC 9309, publiée en 2022, qui a formalisé un protocole né en 1994.
Les erreurs qui rendent un site invisible
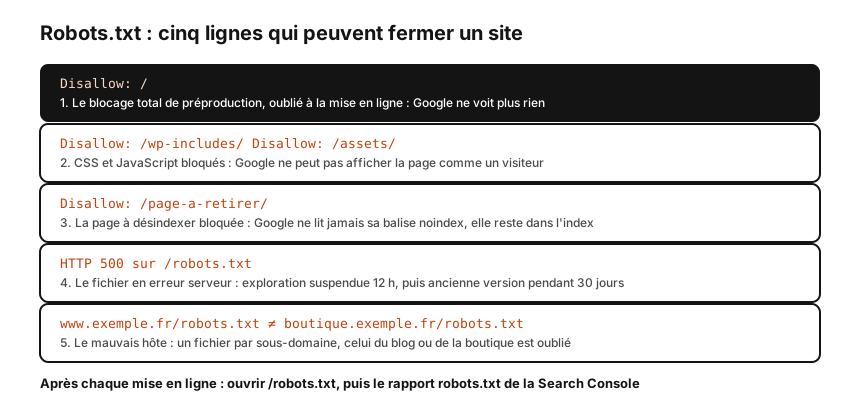
En audit, je retrouve toujours les mêmes :
- Le
Disallow: /de préproduction laissé en place à la mise en ligne. Le site neuf est invisible, et personne ne comprend pourquoi pendant des semaines. - Le blocage des fichiers CSS et JavaScript, hérité d’anciennes habitudes. Google a besoin de les charger pour afficher la page comme un visiteur ; bloqués, il voit une page cassée.
- Le blocage d’une page à désindexer, vu plus haut.
- Le fichier en erreur après une migration ou un changement d’hébergeur : une redirection mal configurée sur
/robots.txtsuffit. - Le mauvais hôte : un fichier soigné sur
www., rien sur le sous-domaine de la boutique ou du blog. - Les chemins approximatifs :
Disallow: /Adminne bloque pas/admin/, la casse compte. - L’illusion de confidentialité : lister dans le robots.txt les dossiers « à cacher » revient à en publier la carte.
Vérifier et surveiller
Deux outils gratuits suffisent. Dans la Google Search Console, le rapport robots.txt montre le fichier tel que Google l’a lu, la date de récupération et les erreurs ; l’inspection d’URL dit si une page donnée est « bloquée par le fichier robots.txt ». Après chaque mise en ligne et chaque migration, ouvrez /robots.txt dans le navigateur et vérifiez trois choses : le fichier répond en 200, il ne contient pas de Disallow: / général, la ligne Sitemap pointe vers la bonne adresse.
Le robots.txt est l’un des six points bloquants de la checklist SEO technique : une minute à vérifier, des mois de visibilité en jeu.
Ce qu’il faut retenir
Ouvrez tout ce qui doit être vu, fermez seulement ce qui gaspille l’exploration, n’utilisez jamais le fichier pour désindexer ou protéger, et testez après chaque changement. Si vous avez un doute sur ce que Google voit ou ne voit pas de votre site, demandez l’aperçu gratuit : vous recevez en moins d’une heure un aperçu de votre visibilité, puis je reviens vers vous sous 24 h ouvrées pour regarder votre robots.txt avec vous. Pour une stratégie complète sur un marché national, c’est l’objet du référencement naturel.